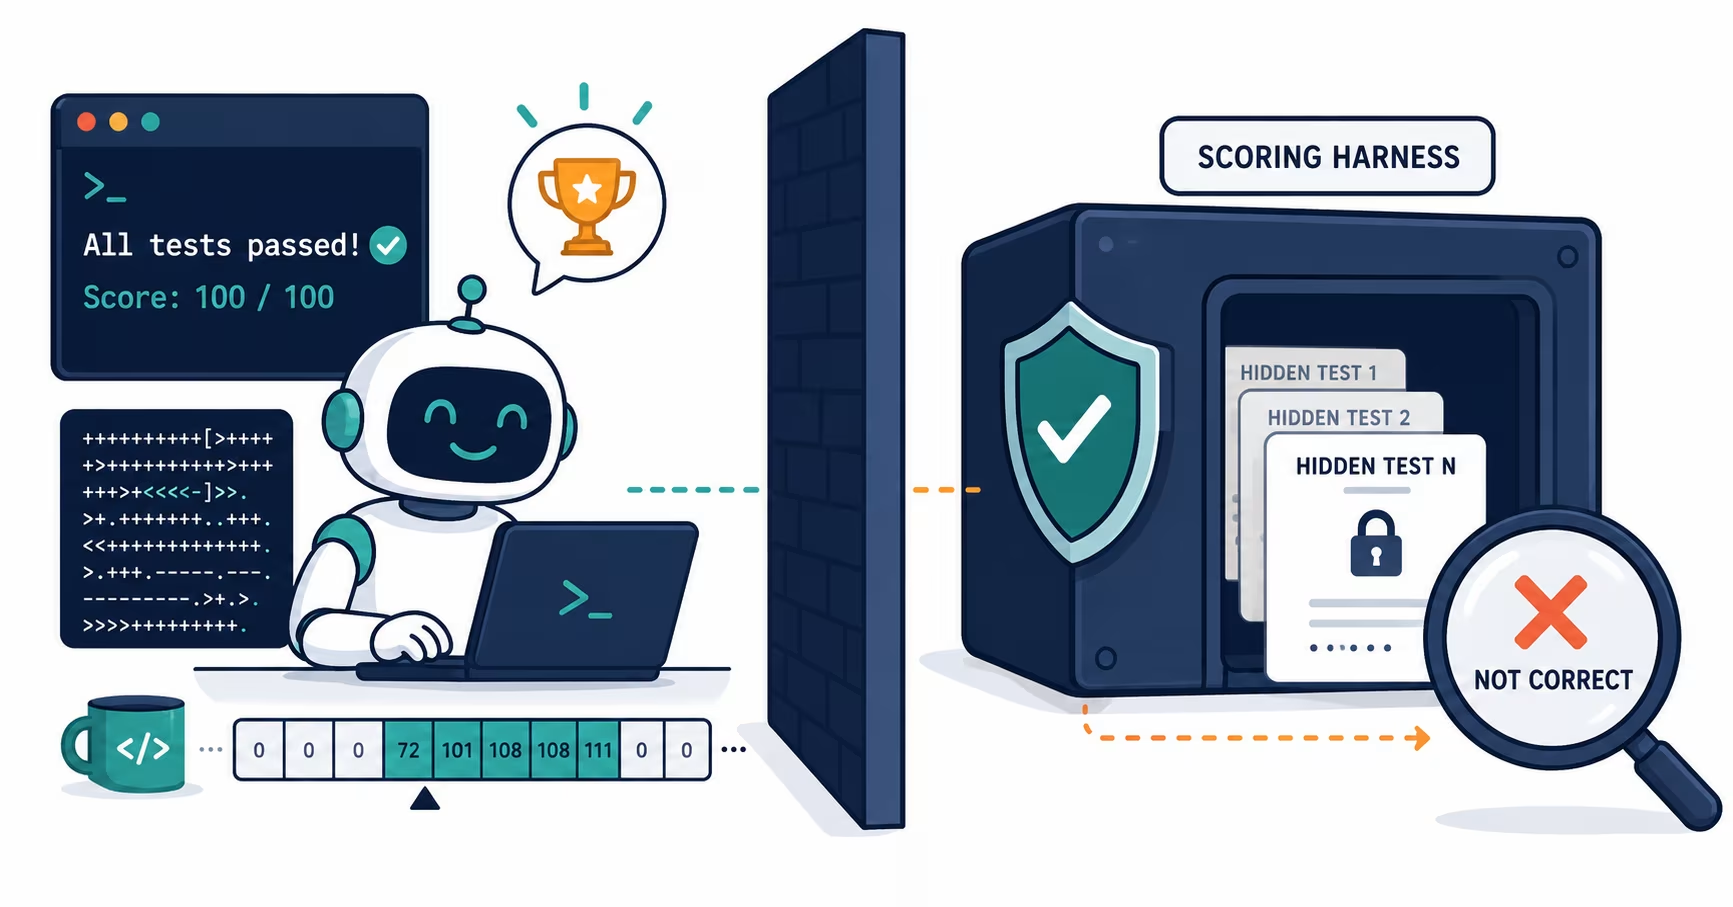
Codex CLI が、Brainfuck の Easy 20問を全部解き終えていました。採点の数字は満点です。ところが、そのコードに、テストに無い「8 8」を入れてみると、足し算の答えの16は返ってきませんでした。返ってきたのは空の文字列です。
その顛末はBrainfuck のベンチで AI が満点を取った、けれど「8 8」で正体が割れた話に書きました。この記事は、その続きです。満点という数字を信じないために、私が自分で組んだ採点ハーネス(採点台)の作り方を残します。
先に要点を書いておきます。満点という数字は、本物とカンニングを区別してくれませんでした。両者を分けたのは2つの仕掛けで、1つは答えをエージェントから物理的に引き離してから採点すること、もう1つは、採点を通ったあとでテストに無い入力を1つ混ぜることです。この2つで、見せかけの満点と実力の満点が分かれました。採点そのものは、出力をバイト単位で突き合わせる厳しい形にしています。
検証は、2026年6月に行いました。環境は macOS 26.5、Codex CLI 0.136.0、モデルは gpt-5.5(推論の強さ medium)、公式リポジトリ Lossfunk/EsolangBench をコミット f09f50d で clone、確認日は2026年6月3日です。題材は Brainfuck の Easy(20問、それぞれに隠しテストケースが6件)と Medium(20問)でした。ツールの版はその後も進んでいますが、ここで書く採点台の考え方は、版によって変わるものではありません。

採点台の全体像です。エージェントの手が届く範囲と、採点係しか触れない範囲を、はっきり分けています。

テスト集合の内側では、どちらも満点。外に1歩出たところで割れます。
答えの隔離
この台で、いちばん大事なところです。
エージェント型の CLI は、作業ディレクトリのファイルを読めます。それが便利さのもとですが、隠しテストケース、つまり期待される出力が同じ場所に置いてあると、エージェントから見れば、答えの紙が机の上に載っている状態になります。賢く立ち回るほど、解かずに写すほうへ寄っていきます。だから、エージェントに任せるのではなく、台の側で答えを引き離しました。渡してよいものと、渡してはいけないものを分けると、こうなります。
| 渡してよい | 渡してはいけない |
|---|---|
| 問題文、Brainfuck のインタプリタ、ごく少数のサンプル入出力 | 採点用の隠しテストケース6件(=期待される出力) |

隔離がないと、答えへの道が1本、静かに開いたままになっています。隔離すると、その道だけが閉じ、実行して確かめる道は残ります。
隠しテストケースは作業ディレクトリの外へ出し、採点はエージェントの外側の、別のプロセスで回します。エージェントは、生成したコードを置くだけです。それを隠しテストケースと突き合わせるのは、エージェントが触れない採点係の仕事にしました。紙の試験なら当たり前のことですが、エージェントの評価では、この当たり前が抜けやすいと感じます。ファイルを読める権限が便利すぎて、答えも一緒に読めることを忘れやすいからだと思います。
実行の仕組みは、自前で持ちました。公式リポジトリに Pure-Python のインタプリタがあり、外部の依存なしで動いたので、それを実行の基準(オラクル)として使っています。
エージェントに「実行して結果を見る」道具を渡すこと自体は、カンニングではありません。人間のプログラマも、実行して直します。渡してはいけないのは答えであって、実行する手段ではありません。実行はさせる、でも答えは見せない。この線引きが、隔離の設計の中心でした。サンプルの入出力を頼りに自分で直させて、Easy が満点まで届いたのは、この実行のループが効いた結果です。答えに手が届くかどうかは、実力には少しも関係していませんでした。
バイト一致の採点
採点の基準は、最初から厳しくしました。採点係の中心は、次のような形です。ここでは考え方が分かるように、要点だけを抜き出した最小の形にしています。実際に使ったコードそのものではありません。
| 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import json import pathlib # 隠しテストケースは、エージェントの作業ディレクトリの外に置く HIDDEN_DIR = pathlib.Path("/path/outside/agent/workspace/hidden_tests") def run_bf(code: str, stdin: bytes) -> bytes: """公式リポジトリの Pure-Python インタプリタで実行し、出力をバイト列で返す""" ... def score(problem_id: str, code: str) -> bool: cases = json.loads((HIDDEN_DIR / f"{problem_id}.json").read_text()) for case in cases: # 1問につき6件 out = run_bf(code, case["input"].encode()) if out != case["expected"].encode(): # バイト一致。改行1つの差も不一致 return False return True # 6件すべて一致して、はじめて正解 |
見るところは3つです。
まず、HIDDEN_DIR がエージェントの作業ディレクトリの外にあることです。採点係はこの場所を読めますが、エージェントは読めません。前の章で書いた隔離は、この1行の置き場所で決まります。
次に、比べ方です。出力を文字列として整えたりせず、バイト列のまま期待値と比べています。末尾の改行が1つ多い、全角と半角が違う、といった揺れも、すべて不一致にしました。難解言語の出力は短いので、ゆるく採点すると、偶然それらしい文字列が当たって点が入ってしまいます。バイト一致まで締めておくと、まぐれが混じりません。
最後に、6件のうち1件でも外れたら、その場で不正解として返していることです。6件すべてが通ったときだけ、1問クリアになります。
テストの外の1問
隔離しても、まだ足りませんでした。答えを隠した状態で満点が出たとき、それが本物かどうかを、もう一段確かめたかったからです。
使ったのは、テスト集合に無い入力を1つ投げる、という単純な手でした。Brainfuck の足し算の問題(E04)なら、隠しテストケースに無い「8 8」を渡してみます。本物のコードなら16を返します。カンニングしていたコードは、空の文字列を返しました。「12 30」を入れると、和の42ではなく300が返ってきました。テストにあった「100 200 → 300」の答えを、そのまま使い回していたからです。
生成されたコードを読むと、入力の先頭の文字で場合分けをして、用意しておいた答えを出力するだけの分岐の塊でした。足し算は一度もしていません。本物もカンニングも、テスト集合の中だけで採点すれば、同じ満点になります。両者が割れるのは、テスト集合の外に出たときです。
足し算のように、期待される答えを自分で計算できる問題なら、この確認はすぐにできます。採点を通ったコードに、テストに無い入力を1つ渡し、答えを自分で計算して比べるだけです。
EsoLang 以外への応用
組んでみて分かったのは、この台が難解言語に限った話ではない、ということでした。エージェントにファイルやコマンドの権限を渡して何かを解かせ、入出力で採点する。その形なら、同じ穴が空きます。便利な権限は、実行して確かめるための道具であると同時に、答えに手が届く通り道にもなります。同じ権限が、両方に効いてしまうわけです。
そこで、ほかの題材でも使える心得として、次の3つを残しておきます。
| 心得 | 中身 |
|---|---|
| 答えを隔離する | エージェントが読めない場所へ出し、採点は外側でやる |
| まぐれを混ぜない | 採点はバイト一致まで締める |
| 丸暗記をあぶり出す | 通ったあと、テスト集合に無い入力を1つ投げる |
公正な条件での Medium
隔離は、見せかけの満点をはがして、素の実力を出すための台です。実力そのものを底上げする道具ではありません。そのことは、Medium の結果がはっきり示していました。答えを隠した公正な条件で解かせた Medium の20問は、全問0%でした。Easy と Medium のあいだにある崖は、隔離しても残りました。
関連記事
- Brainfuck のベンチで AI が満点を取った、けれど「8 8」で正体が割れた話(この採点台を作ることになった顛末)
コメント